Compartir:
La extracción de datos estructurados de documentos sigue siendo un desafío significativo para numerosas empresas. Con la variabilidad en formatos, diseños y lenguajes, la estandarización se complica, mientras que los métodos manuales son lentos y propensos a errores. Tecnologías tradicionales como el reconocimiento óptico de caracteres (OCR) y los sistemas basados en reglas a menudo resultan insuficientes para enfrentar esta complejidad. Un banco regional, por ejemplo, podría deber procesar miles de documentos variados, como solicitudes de préstamo y declaraciones de impuestos, donde el procesamiento manual puede generar cuellos de botella y aumentar el riesgo de errores.
El procesamiento inteligente de documentos (IDP) busca resolver estos inconvenientes utilizando inteligencia artificial para clasificar documentos, extraer información relevante y validar datos extraídos, facilitando su utilización en procesos empresariales. Su meta principal es transformar documentos no estructurados o semi-estructurados en formatos utilizables y estructurados, como JSON.
Un avance revolucionario en este dominio son los modelos de lenguaje visual (VLM). Estos modelos integran grandes modelos de lenguaje (LLM) con codificadores de imágenes especializados, ofreciendo capacidades de inteligencia artificial multimodal para el razonamiento textual y la interpretación visual. A diferencia de las herramientas de procesamiento de documentos tradicionales, los VLM analizan los documentos de forma más integral, permitiendo extraer sentido con una precisión y comprensión contextual sin precedentes.
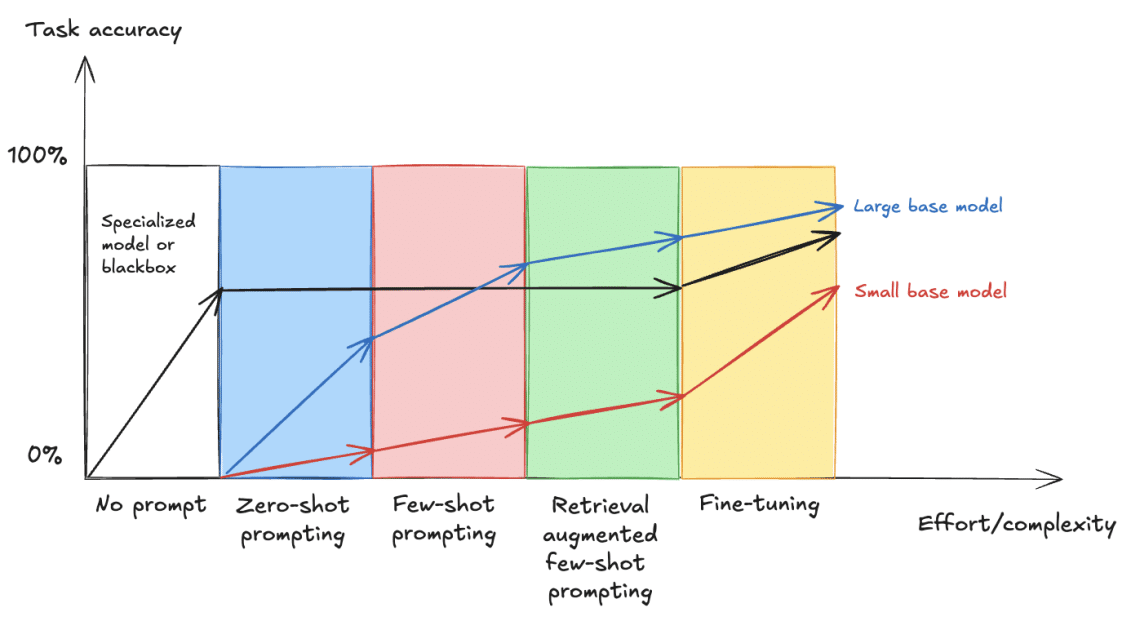
La comprensión e implementación de estas tecnologías puede parecer un desafío, sin embargo, se presentan distintos enfoques dentro del IDP, incluidos métodos de ajuste fino que representan una solución escalable recomendada. Este proceso utiliza un marco conocido como Swift, que facilita el ajuste fino de modelos de lenguaje visual para convertir documentos en formatos JSON.
El proceso de preparación de datos es igualmente crucial. Para el ajuste fino de modelos, se aconseja emplear conjuntos de datos bien estructurados con ejemplos anotados, permitiendo a los modelos aprender patrones específicos relacionados con el tipo de documentos que se procesarán.
Finalmente, después de ajustar un modelo, es esencial evaluar su rendimiento. Medidas como la tasa de error de caracteres y el índice de coincidencia exacta son fundamentales para entender la calidad de los datos extraídos y asegurar que cumplan los estándares requeridos por las empresas.
Las posibilidades para optimizar y expandir esta tecnología son vastas, abriendo la puerta a soluciones automatizadas en el procesamiento de documentos y la generación de información estructurada que podría impactar positivamente la eficiencia operativa de las organizaciones.