Compartir:
Los modelos de inteligencia artificial generativa continúan creciendo, lo que incrementa la necesidad de inferencias más rápidas y eficientes. En respuesta a esta demanda, Amazon SageMaker AI ha introducido notables mejoras en su conjunto de herramientas de optimización. La novedad está en la decodificación especulativa adaptativa basada en EAGLE (Extrapolation Algorithm for Greater Language-model Efficiency), que ahora se aplica a más arquitecturas de modelos. Estas actualizaciones permiten acelerar la decodificación, mejorar el rendimiento con datos del usuario y desplegar modelos de alto rendimiento mediante un flujo de trabajo conocido en SageMaker AI.
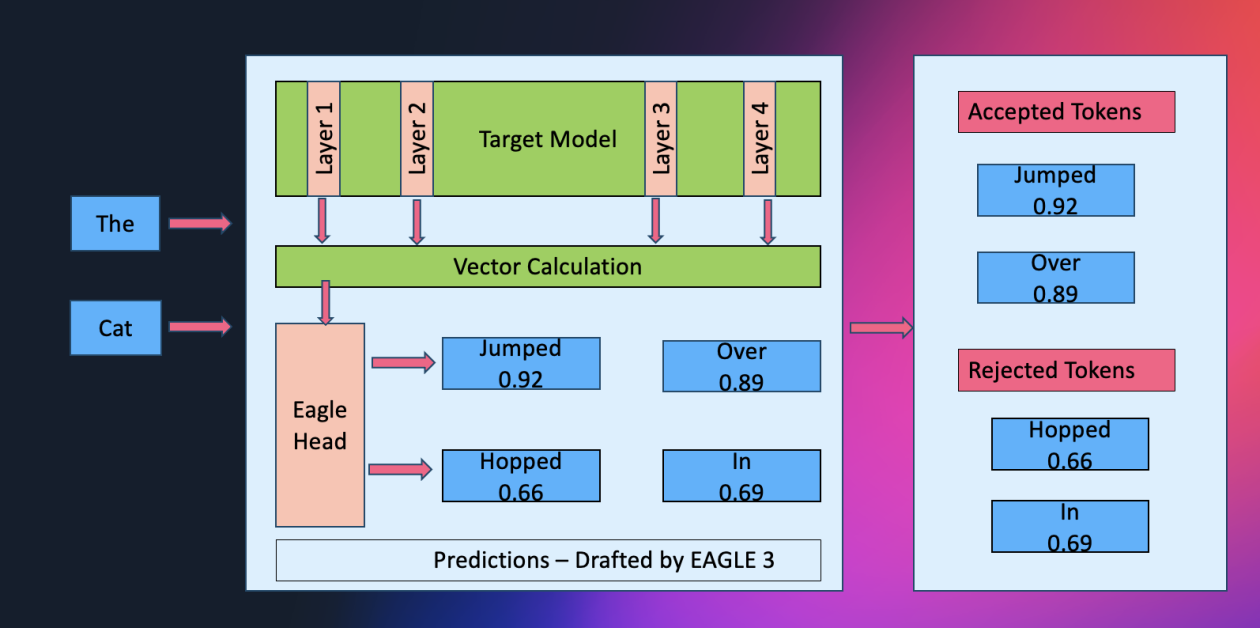
EAGLE es una técnica que adelanta la decodificación de grandes modelos de lenguaje al anticipar tokens futuros desde las capas ocultas del modelo. Esta innovación se adapta a los patrones y dominios reales, ofreciendo inferencias más rápidas y relevantes para las cargas de trabajo específicas del usuario, en vez de basarse en medidas estándar. SageMaker AI entrena cabezales EAGLE 3 o EAGLE 2 según la arquitectura del modelo en cuestión.
El proceso de entrenamiento y optimización no es una operación única. Los usuarios pueden utilizar conjuntos de datos iniciales proporcionados por SageMaker, pero también tienen la opción de afinar el modelo con sus propios conjuntos de datos, logrando una performance adaptativa y específica. Por ejemplo, una herramienta como Data Capture puede compilar conjuntos de datos a partir de solicitudes en tiempo real al modelo.
SageMaker AI ofrece soporte nativo para EAGLE 2 y EAGLE 3, lo que permite aplicar la técnica más adecuada a cada modelo. Se pueden emplear modelos JumpStart de SageMaker o importar modelos de otros repositorios, como HuggingFace, otorgando gran flexibilidad.
La decodificación especulativa, técnica comúnmente usada para acelerar inferencias sin comprometer calidad, ahora utiliza un modelo base más pequeño que genera tokens preliminares, luego verificados por el modelo destinatario. Con EAGLE, se optimizan resultados reutilizando características del modelo objetivo, siendo crucial una buena selección del modelo base.
El enfoque de EAGLE permite que el modelo actúe como su propio socio experimental. Examina sus representaciones internas para prever varios tokens futuros simultáneamente, reduciendo inferencias lentas y mejorando la precisión. Este método también alivia los cuellos de botella de memoria, resultando en mejoras significativas en rendimiento.
Los usuarios pueden construir o refinar modelos EAGLE de múltiples maneras: desde cero con conjuntos de datos de SageMaker, utilizando sus propios datos, o partiendo de un modelo base existente. SageMaker JumpStart también ofrece modelos EAGLE preentrenados, facilitando la optimización inmediata.
Estas mejoras permiten que la optimización refleje el comportamiento específico de cada aplicación, resultando en un rendimiento superior de extremo a extremo. La herramienta de optimización está diseñada para ayudar a desarrolladores a crear aplicaciones generativas con menor latencia y mayor escalabilidad, ahorrando tiempo considerable en procesamiento y manejo de datos.