Compartir:
Leer un documento largo parece una tarea sencilla para cualquier persona acostumbrada a trabajar con PDFs. Se abre el archivo, se pasa de una página a otra y se entiende que todo forma parte del mismo texto. Para un sistema de inteligencia artificial, sin embargo, esa continuidad no siempre existe. Muchos programas de reconocimiento óptico de caracteres, más conocido como OCR, siguen tratando los documentos página a página. Primero leen una hoja, luego otra, después intentan unirlo todo y finalmente entregan el resultado a una herramienta de búsqueda o análisis.
Ese proceso funciona razonablemente bien con documentos simples, pero empieza a fallar cuando el PDF tiene muchas páginas, tablas partidas, notas al pie, columnas, gráficos, fórmulas o referencias cruzadas. Un contrato, un informe administrativo, una investigación científica o un manual técnico no son una suma de páginas sueltas. Son documentos con contexto, estructura y continuidad.
Baidu, una de las grandes tecnológicas chinas, ha presentado Unlimited-OCR, un modelo abierto que busca mejorar precisamente ese punto. Su propuesta consiste en procesar documentos largos de una forma más parecida a como los lee una persona: manteniendo visible el documento completo para el modelo y reduciendo la dependencia de reconstrucciones posteriores. El proyecto está disponible en GitHub, Hugging Face y arXiv bajo licencia MIT, lo que facilita su uso, revisión y adaptación por parte de investigadores y desarrolladores.
Por qué los PDFs siguen siendo difíciles para la IA
El OCR tradicional nació para una tarea muy concreta: convertir imágenes de texto en texto editable. En una factura escaneada, una carta o una página sencilla, el resultado suele ser bastante bueno. El problema aparece cuando el documento no es una página aislada, sino un conjunto largo y complejo.
En muchos flujos actuales, un PDF se convierte primero en imágenes. Después, cada página se procesa por separado. Más tarde, otro sistema intenta reconstruir el orden correcto de lectura, reconocer dónde empieza y termina una tabla, separar títulos de párrafos, respetar columnas y preparar el contenido para que una IA pueda consultarlo. Cada paso puede introducir errores.
Esto importa más de lo que parece. Si el texto extraído de un documento está mal ordenado, incompleto o mezclado, cualquier sistema posterior trabajará sobre una base defectuosa. Un asistente que responde preguntas sobre un contrato puede equivocarse porque la cláusula estaba bien escrita, pero fue extraída fuera de contexto. Un buscador interno puede no encontrar una respuesta porque el OCR rompió una tabla. Una herramienta de resumen puede omitir información relevante porque el documento fue fragmentado de forma incorrecta.
Unlimited-OCR intenta reducir ese trabajo de “cortar y pegar” digital. Su objetivo no es solo reconocer palabras, sino mantener mejor la continuidad del documento durante el proceso de lectura.
Qué propone Unlimited-OCR
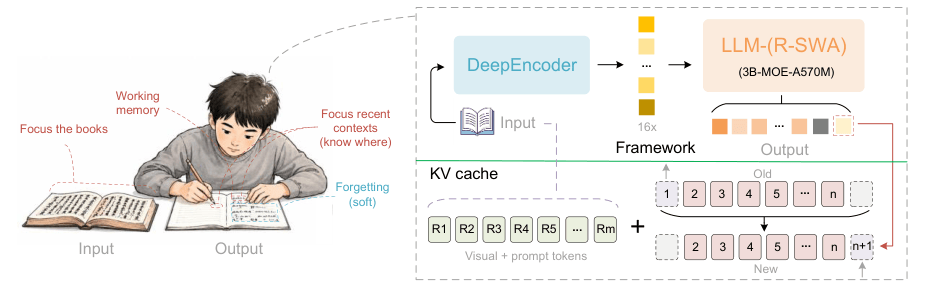
La novedad principal de Unlimited-OCR está en la forma de gestionar la memoria del modelo mientras genera texto. En muchos modelos de visión y lenguaje, cuanto más larga es la salida, más memoria se necesita. El sistema va acumulando lo que ha generado y eso aumenta el coste de proceso, la latencia y las necesidades de hardware.
Baidu introduce una técnica llamada Reference Sliding Window Attention. En términos sencillos, el modelo conserva la referencia visual del documento, pero solo mantiene una ventana reciente del texto que va generando. Es decir, no arrastra toda la salida anterior con el mismo peso en cada paso. Así puede trabajar con documentos más largos sin que el consumo de memoria crezca de forma descontrolada.
La idea recuerda a una lectura con el documento siempre delante y unas notas recientes sobre lo que se acaba de transcribir. El modelo sigue viendo la fuente, pero no necesita cargar cada palabra generada desde el inicio como si tuviera la misma importancia en todo momento.
Esto puede ser especialmente útil en documentos de muchas páginas. En vez de procesar una página, cerrar esa tarea y pasar a la siguiente, Unlimited-OCR permite enviar varias páginas al modelo dentro de una misma operación de análisis. El PDF se convierte antes en imágenes, pero esas imágenes se tratan como parte de una lectura multipágina.
| Método | Cómo trabaja | Problema habitual |
|---|---|---|
| OCR por página | Lee cada hoja por separado | Puede perder continuidad |
| OCR clásico con reconstrucción | Une después el texto extraído | Puede mezclar orden, tablas o columnas |
| IA con salida larga tradicional | Mantiene mucho contexto generado | Consume más memoria a medida que crece la salida |
| Unlimited-OCR | Mantiene la referencia visual y una ventana de texto reciente | Sigue limitado por la calidad de las imágenes y el contexto disponible |
Para qué puede servir en la vida real
Aunque se trata de una herramienta técnica, sus posibles usos son fáciles de entender. Muchas empresas, administraciones y profesionales trabajan con miles de PDFs acumulados durante años: expedientes, informes, contratos, actas, manuales, facturas, documentación legal, historiales, publicaciones académicas o archivos históricos. Convertir todo eso en información útil sigue siendo una tarea costosa.
La inteligencia artificial puede ayudar a buscar, resumir o responder preguntas sobre esos documentos, pero antes necesita que el texto esté bien extraído. Ahí es donde el OCR largo se vuelve importante. No basta con reconocer caracteres. Hay que respetar el orden de lectura, las relaciones entre secciones y la estructura del documento.
En un despacho jurídico, por ejemplo, una herramienta así podría mejorar la lectura de contratos extensos o documentación procesal escaneada. En una administración pública, podría facilitar el análisis de expedientes antiguos. En una empresa industrial, serviría para convertir manuales técnicos en contenido consultable por asistentes internos. En investigación, ayudaría a procesar artículos científicos con tablas, fórmulas y referencias.
También puede ser relevante para sistemas RAG, es decir, sistemas que permiten a una IA consultar una base documental antes de responder. Si el documento entra mal en esa base, la respuesta final será menos fiable. Por eso, aunque el OCR parezca una capa poco llamativa, es una pieza crítica de muchas aplicaciones de IA.
No es una solución mágica
El nombre Unlimited-OCR puede sugerir que el modelo no tiene límites, pero esa lectura sería exagerada. El propio enfoque sigue condicionado por el tamaño de contexto disponible, por la memoria del sistema, por la calidad de las imágenes y por la complejidad del documento. Si una página está borrosa, torcida, escaneada con poca resolución o contiene letra muy pequeña, ningún modelo puede garantizar una lectura perfecta.
Tampoco es una herramienta pensada para usuarios sin conocimientos técnicos. El repositorio incluye ejemplos de uso con Transformers, SGLang, GPU NVIDIA y conversión previa de PDFs a imágenes mediante PyMuPDF. Es decir, está más cerca de un proyecto para desarrolladores, investigadores y equipos de IA que de una aplicación de escritorio lista para cualquier oficina.
Aun así, su publicación abierta es relevante. Permite probar el modelo, compararlo con otros sistemas, adaptarlo a flujos internos y estudiar si este tipo de atención con ventana deslizante puede mejorar el procesamiento de documentos largos. La licencia MIT también facilita la experimentación en proyectos comerciales o académicos.
La dirección que marca Baidu es clara: la próxima mejora en IA documental no vendrá solo de modelos más grandes, sino de modelos que sepan leer mejor durante más tiempo y con menos coste. Para muchas organizaciones, esa diferencia puede ser más útil que una mejora espectacular en una demo breve.
El reto de fondo es convertir archivos acumulados durante años en conocimiento consultable. Gran parte de la información de empresas y administraciones sigue encerrada en PDFs. Algunos son digitales, otros escaneados, otros mezclan texto e imagen, y muchos no fueron creados pensando en la inteligencia artificial. Herramientas como Unlimited-OCR intentan tender un puente entre ese archivo documental y los nuevos sistemas capaces de buscar, resumir y razonar sobre información.
La promesa no es que una IA “entienda” todos los documentos sin errores. La promesa es más modesta y más útil: leer mejor, perder menos contexto y reducir el trabajo manual de reconstrucción. En el mundo real, donde los documentos rara vez son perfectos, esa mejora puede marcar una diferencia importante.
Preguntas frecuentes
¿Qué es Unlimited-OCR?
Unlimited-OCR es un modelo abierto de Baidu para reconocer y analizar documentos largos, especialmente PDFs de varias páginas, reduciendo la necesidad de procesarlos hoja por hoja.
¿En qué se diferencia de un OCR tradicional?
Un OCR tradicional suele leer cada página por separado. Unlimited-OCR intenta mantener más contexto del documento y gestionar mejor la memoria durante salidas largas.
¿Puede leer cualquier PDF sin errores?
No. Sigue dependiendo de la calidad del documento, la resolución de las imágenes, la estructura de las páginas y los límites técnicos del modelo.
¿Por qué importa para la inteligencia artificial?
Porque muchos sistemas de IA trabajan con documentos. Si el texto se extrae mal, las búsquedas, resúmenes y respuestas posteriores también pueden fallar.