Compartir:
Los sistemas de inteligencia artificial (IA) continúan perpetuando prejuicios de género al asociar ciertas profesiones principalmente con hombres, incluso cuando las referencias no especifican el género. Esta es la conclusión de un reciente estudio realizado por investigadoras del Centro Vasco de Tecnología del Lenguaje de la Universidad del País Vasco (EHU). Las investigadoras han desarrollado innovadoras herramientas de evaluación para identificar y corregir estos sesgos en diversos idiomas.
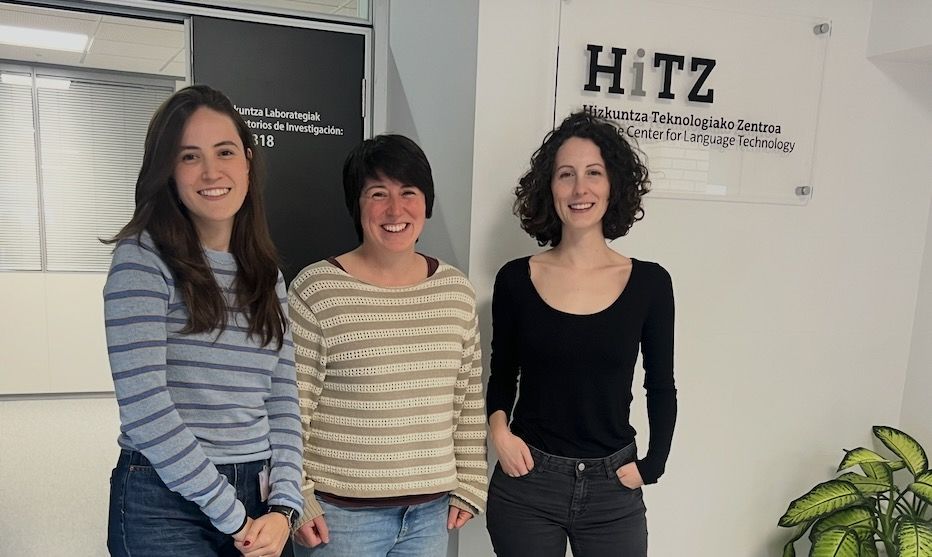
El trabajo fue presentado en la conferencia internacional LREC 2026 por Amaia Murillo, Olatz Perez de Viñaspre y Naiara Perez. La investigación se centra en cómo los sistemas de IA tratan las referencias de género en idiomas como el euskera, que carece de género gramatical. Términos como «irakaslea» (docente) o «garbitzailea» (personal de limpieza) no especifican si se refieren a una mujer o a un hombre, lo cual presenta un desafío para su traducción a lenguas que sí distinguen géneros, como el castellano o el francés.
Para enfrentar esta problemática, las investigadoras han creado dos recursos evaluativos: WinoMTeus y FLORES+Gender. Estas herramientas son pioneras, permitiendo medir cómo los modelos de IA asignan el género en traducciones vinculadas al euskera. La mayoría de los recursos actuales están diseñados para el inglés, sin considerar las particularidades de otros idiomas.
Los resultados revelan que los modelos de IA tienden a asignar género de manera sesgada en las traducciones, eligiendo con frecuencia formas masculinas, incluso para profesiones donde predominan las mujeres. Además, se han identificado diferencias en el rendimiento de los modelos al procesar referencias masculinas y femeninas.
Más allá de identificar estas limitaciones, el principal aporte de la investigación es la creación de herramientas que permitirán una evaluación rigurosa del comportamiento de los sistemas de inteligencia artificial en contextos multilingües. Las investigadoras destacan la importancia de contar con métricas adaptadas a diversas lenguas como un paso esencial para desarrollar tecnologías más inclusivas y representativas de la realidad social.
La inclusión de lenguas menos representadas, como el euskera, en la investigación internacional sobre IA no solo contribuye a preservar la diversidad lingüística, sino que también permite identificar sesgos que pueden ser invisibles en modelos entrenados mayoritariamente con datos de idiomas dominantes.