

Compartir:
Amazon ha optimizado su plataforma Amazon Search mediante la utilización de AWS Batch para mejorar el entrenamiento de modelos de aprendizaje automático (ML) en SageMaker. Esta integración permite una orquestación más eficiente de las cargas de trabajo en instancias de GPU, lo que facilita a los clientes encontrar productos de manera más relevante.
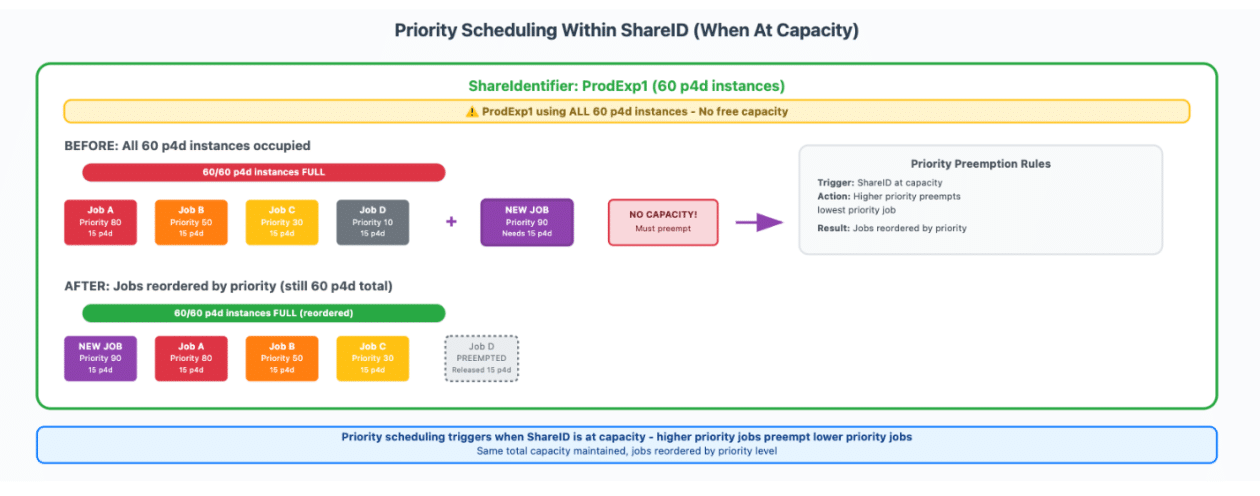
En el sistema de Amazon Search, se utilizan cientos de instancias de GPU para entrenar modelos de ML, donde los científicos evalúan múltiples modelos simultáneamente para identificar las mejores características y arquitecturas. Anteriormente, se empleaba un sistema FIFO para gestionar los trabajos de modelado, pero la creciente necesidad de una asignación de prioridades más detallada motivó la búsqueda de una solución más avanzada. Era crucial establecer un sistema donde los modelos de producción tuvieran prioridad alta, las investigaciones exploratorias prioridad media, y los análisis de hiperparámetros prioridad baja.
Tras considerar varias opciones, se decidió implementar AWS Batch para coordinar los trabajos en SageMaker. Esta decisión permitió gestionar tareas según su prioridad, aumentando la eficacia del uso de las GPU de un 40% a más del 80%. La implementación incluyó definir la capacidad total de GPU disponible y el uso de identificadores para priorizar las cargas de trabajo.
Amazon CloudWatch juega un papel crucial en esta configuración, monitorizando los trabajos de entrenamiento y activando alertas en eventos críticos, lo que proporciona visibilidad en tiempo real y análisis histórico de tendencias. Esto mantiene la eficiencia operativa en los clústeres de GPU.
La adopción de AWS Batch ha tenido un impacto significativo al permitir experimentos simultáneos sin preocuparse por la disponibilidad de recursos, reduciendo tiempos de espera y mejorando los plazos de entrega de resultados. Esta mejora operativa sugiere que otras organizaciones que enfrentan desafíos similares en su infraestructura de ML podrían beneficiarse al integrar AWS Batch con SageMaker, eliminando la gestión manual de recursos y ofreciendo una programación eficiente basada en prioridades.








