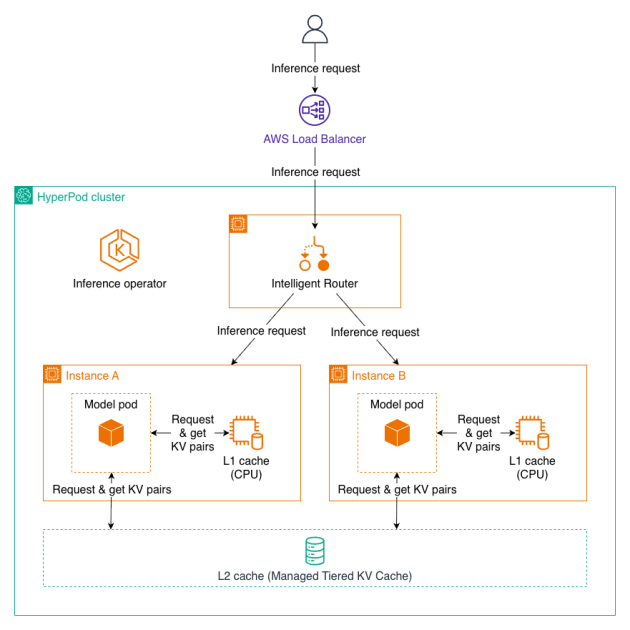
Cacheo Jerárquico Gestionado y Enrutamiento Inteligente para HyperPod de Amazon SageMaker
En el mundo actual, las aplicaciones de inteligencia artificial moderna exigen respuestas rápidas y rentables de los modelos de lenguaje grande (LLM), especialmente en el manejo de documentos extensos y conversaciones prolongadas. Sin embargo, el proceso de inferencia de LLM puede volverse cada vez más lento y costoso a medida